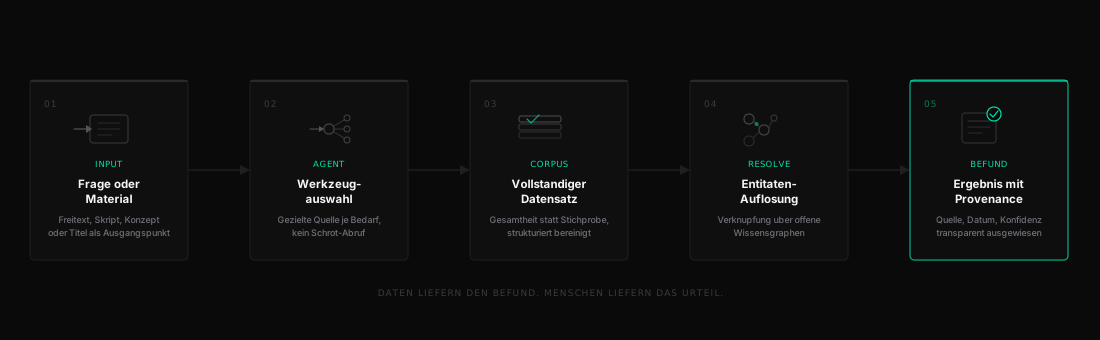
Daten liefern den Befund, Menschen liefern das Urteil.
CineCockpit gibt Produzent*innen und Produktionsfirmen den strukturierten Daten-Unterbau, den Sendergespräche, Förderanträge und Finanzierungsrunden heute voraussetzen. Jeder Stoff und jedes Konzept wird gegen öffentliche Register und offene Quellen abgeglichen. Sechs Datenblöcke pro Werk, Markt-Query auf Knopfdruck, jede Aussage mit Quelle und Datum.
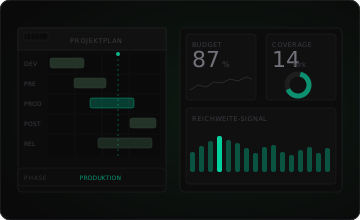
Ein eingereichtes Package zu beurteilen bedeutet heute: Erfahrung, Gesprächspartner anrufen, Google. Das ist langsam und lückenhaft. Wer weiß, welche Tonalitäten und Milieukombinationen in Europa gerade überlaufen oder freies Feld sind, trifft die Entscheidung besser.
Comparables benennen, Zielgruppen-Argument liefern, Marktpotenzial einordnen: was beim Gegenüber als Vorbereitung gilt, kostet intern Tage und haengt oft an einer Handvoll Quellen ohne Datum. Ein belegtes Datenblatt veraendert die Ausgangslage im Raum.
Förderkommissionen und Koproduzenten erwarten Markteinordnung. Nachfrage-Signale, White-Space-Analyse, Vergleichstitel mit Verwertungsweg: wer das strukturiert liefert, statt es zu behaupten, hat einen anderen Stand im Gespräch.
CineCockpit begleitet den Entwicklungsprozess vom ersten Stoff-Entwurf bis zum fertigen Pitch-Package. Drehbuch- und Stoffanalyse, Abgleich gegen öffentliche Datenbestaende und Branchenregister, Vergleich mit verwandten Verwertungswegen: alles in einem Arbeitsablauf.
Themen, Tonalität, Milieu und Formatklasse eines Stoffs werden gegen öffentliche Werk-Register und Branchen-Metadaten abgeglichen. Das ergibt einen strukturierten Ersteindruck: was ist verwandt, was ist ähnlich, wo ist das Feld voll, wo frei.
Jede Abfrage, jeder Abgleich und jede Annotation reichert die Datenblätter der betreffenden Stoffe und Kreativen an. Das Living Sheet eines Werks wird dichter, präziser und vergleichsreicher, je öfter es im Arbeitsablauf genutzt wird. Kein Zusatzaufwand, automatisch.
Jeder Titel im DACH-Bestand kann auf sechs strukturierten Ebenen abgefragt werden. Die Antwort trägt Quelle, Datum und Konfidenz-Indikator.
Titel, Genre-Taxonomie, Erscheinungsjahr, Laenge, Produktionsland, Erstausstrahlung oder Kinostart, Sprachversion, Formatklasse. Alles normiert auf ein einheitliches Schema, das direkten Vergleich erlaubt.
Kino-Auswertungsdaten (Starts, Laufzeit, Besucherzahlen aus öffentlichen Korpora), TV-Erstplatzierung, bekannte Streaming-Fenster. Kein Prognoseversprechen, sondern belegter Ist-Stand mit Quellenangabe.
Aggregierte Publikumsbewertungen öffentlicher Plattformen, Sentiment-Tendenz aus Kritikerkorpora, Resonanz-Indikatoren aus Suchinteresse-Signalen. Kein Social-Listening-Ersatz, aber ein belegter Ersteindruck.
Werkgeschichte, Genre-Muster und Tonalitäts-Profil von Regie, Buch oder zentralen kreativen Positionen aus öffentlichen Quellen. Hilft, Packaging-Entscheidungen gegenüber Partnern und Förderern einzuordnen.
Für Stoffe mit literarischer Vorlage, Remake-Grundlage oder Franchise-Bezug: Adaptionsgeschichte, Rechtelage-Hinweise aus öffentlichen Quellen und Vergleich mit verwandten Verwertungswegen in Europa.
Öffentlich bekannte Produktionen in Entwicklung oder angekündigter Auswertung mit ähnlichem Tonalitäts- oder Themen-Profil. Kein Geheimdienstool, aber ein frühzeitiger Überblick über den sichtbaren Wettbewerb.
Alle sechs Datenblöcke können per Chat-Anfrage für ein konkretes Werk abgerufen werden. Jede Aussage trägt Quellenindikator, Erhebungsdatum und Konfidenz-Klasse (hoch / mittel / gering). Kein erfundener Befund.
CineCockpit bindet eine erweiterbare Sammlung offener Datenquellen, Branchen-Register, Plattform-Signale und Community-Daten an. Keine Daten-Monokultur: Quellen und Schnittstellen sind neutral benannt, austauschbar und ergaenzbar. Wer heute eine Quelle nutzt, ist morgen nicht darauf angewiesen.
Öffentliche Werk- und Metadaten-Register, offene Wissensgraphen für Entitäten-Auflösung, Nachfrage- und Suchinteresse-Signale, Reichweiten- und Resonanzsignale öffentlicher Plattformen sowie Box-Office-Korpora DACH/EU. Jede Quelle ist benannt und datiert.
Das System läuft auf EU-Infrastruktur. KI-Modelle sind austauschbar und können lokal betrieben werden. Datenhoheit liegt beim Kunden. DSGVO-Konformität ist Architektur, nicht Beiwerk. Wer sensible Stoffe und Konzepte in der Entwicklung schützen muss, findet hier die richtige Grundlage.
Eine einzige Chat-Frage genuegt, um Demand-Signale (Suchinteresse, Resonanz-Indikatoren) und Supply-Seite (aktuell sichtbare Produktionen in dem Segment) gegenueberzustellen. Das Ergebnis zeigt, wo Nachfrage und Angebot auseinanderfallen.
"Wie verhält sich Nachfrage zu verfuegbarem Angebot bei Coming-of-Age-Dramen mit laendlichem Setting in Europa, 2022 bis heute?"
Kein Befund ohne Herkunft. Jede Aussage von CineCockpit trägt einen strukturierten Quellenindikator mit Quelltyp, Erhebungsdatum und Konfidenz-Klasse. Das erlaubt es, Argumente im Sendergespräch oder Förderantrag zu verankern, ohne selbst die Rohquelle nachschlagen zu müssen.
"Küstenmilieu-Dramen mit Coming-of-Age-Kern sind im DACH-Kino 2022-2026 mit weniger als fuenf öffentlich dokumentierten Titeln vertreten."
Der Weg von der Rohdaten-Abfrage zum belastbaren Argument für Sendergespräch oder Förderantrag ist in CineCockpit direkt. Kein Export in Zwischensysteme, kein manuelles Zusammenstellen. Das Datenblatt ist das Argument.
Ein typischer Arbeitsablauf für eine Produktionsfirma, die ein Sendergespräch und einen Förderantrag in derselben Woche vorbereitet.
Titel und Genre-Tags eingeben. CineCockpit zieht sofort verfügbare Stammdaten aus öffentlichen Werk-Registern und legt das Living Sheet an. Alle sechs Datenblöcke sind ab diesem Moment abfragbar.
Chat-Frage nach Vergleichsproduktionen im definierten Tonalitäts- und Milieu-Korridor. Die Antwort listet Vergleichstitel mit Produktionsjahr, Erstausstrahlung und Tonalitäts-Schnittmenge. Jede Aussage trägt Quellenindikator und Erhebungsdatum.
Demand- und Supply-Abfrage für das konkrete Segment. Wo ist das Angebot dünn, obwohl Nachfrage-Signale vorhanden sind? Das Ergebnis ist das Förderungs- und Finanzierungsargument: nicht eine Behauptung, sondern ein belegter Befund.
Marken-Analyse der zentralen kreativen Positionen aus öffentlichen Quellen: Werkgeschichte, Genre-Muster, bekannte Projekte in der Pipeline. Ergibt das Packaging eine konsistente Geschichte, die sich belegt erzaehlen lässt?
Sendergespräch, Förderausschuss, Finanzierungsrunde: das Living Sheet liegt vor, die Comparables sind belegt, das White-Space-Argument ist mit Quelle und Datum hinterlegt. Das Urteil und die Entscheidung liegen bei Ihnen.
Ein eingereichtes Package schnell einordnen: Tonalität überlaufen oder freies Feld? Vergleichbare Produktionen identifizieren. Entscheidungsgrundlage in Minuten, nicht Tagen.
Demand-Supply-Query für ein Themen- oder Tonalitäts-Segment. Wo ist das DACH-Angebot dünn? Wo treffen Nachfrage-Signale auf wenig sichtbare Produktion? White Space als Entwicklungs-Ausgangspunkt.
Alle sechs Datenblöcke für einen Titel: Stammdaten, Kommerz-Werte, Sentiment, Urheber-Profil, Adaptions-Comparables, Pipeline. Für Slate-Entscheidungen und umfangreiche Einzelanalysen.
"Das Argument sitzt anders, wenn es nicht von mir kommt, sondern aus belegten Daten. Den Unterschied merkt man spaetestens dann, wenn das Gegenüber nachfragt."
Produzent, unabhängige Produktionsfirma, DACH
Pilotnutzer, Sommer 2026
CineCockpit zieht aus einer erweiterbaren Sammlung offener Datenquellen und Branchen-Register, provider-neutral und austauschbar. Keine Daten-Monokultur, kein Lock-in.
Datenbasis im Detail ansehenIn einer 30-minütigen Live-Session zeigen wir, wie CineCockpit mit einem konkreten Package aus Ihrer Pipeline arbeitet. Keine Demonstration, sondern ein echter Arbeitsablauf.
Verfügbarkeit: Für Development- und Redaktionsteams in Europa. Von Regie und Autor*innen bis Produktion, Studio, Sender und Streaming.